前言
终于有机会来写写关于这个话题的东西了。两三个月前,“暂停执行已缓存的应用” 被当作 安卓版的 “墓碑后台” 大火了一阵。
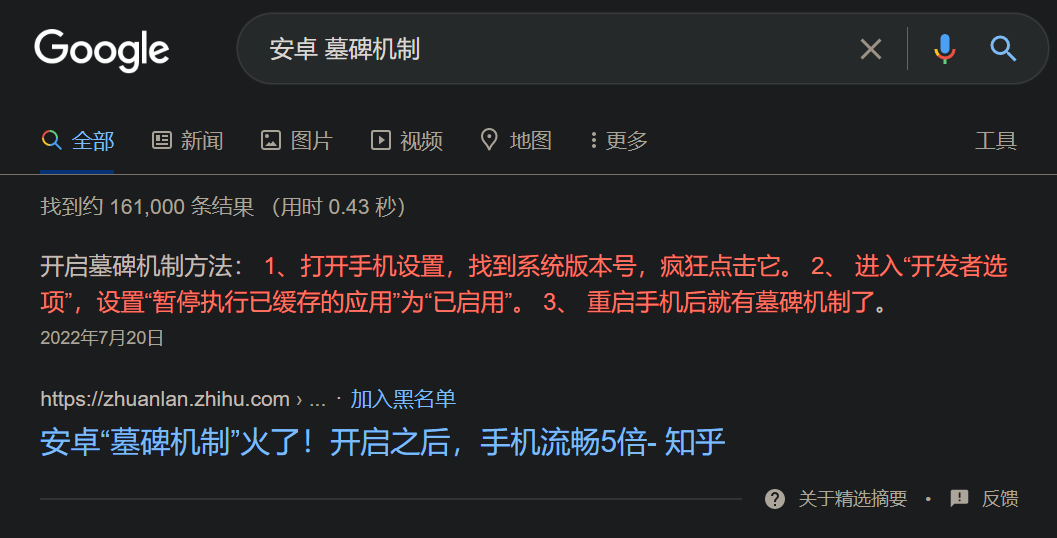
imo 这一切只是以讹传讹,是人类愚蠢和安慰剂效应的再次体现。这个功能在 Android 11 后期下放到 Pixel 时,对它的误解就已经开始。
通过这篇文章,我希望你能够了解它是如何工作的。
文章只针对 Pixel 自带系统和 AOSP,若厂商对其有任何魔改则不算数。
文章基于 Android 12L。
原理基础
冻结
“暂停执行已缓存的应用” 在内核层面使用的是 cgroup freezer,具体来说是 cgroup v2 freezer。相较于使用信号 SIGSTOP 与 SIGCONT 实现的挂起与恢复,cgroup freezer 无法被拦截或观察到,具有对用户程序完全透明的特性。
对于 cgroup freezer 在内核中的工作方式,此处不再深入展开。需要知道的只有——假如一个程序被 freezer “冻结”住,它将完全被“暂停”,不再消耗任何 CPU 资源。直观的感受就是这个程序进入了“未响应”状态。嗯,假如它在前台,那它确实会“未响应”——无法对任何交互操作做出反馈,系统甚至还会弹一个 ANR 对话框。
cgroup v1
cgroup 本身就在 Android 系统中有广泛的应用:
4829 4751 0:23 / /dev/blkio rw,nosuid,nodev,noexec,relatime master:15 - cgroup none rw,blkio
4868 4751 0:25 / /dev/cpuctl rw,nosuid,nodev,noexec,relatime master:17 - cgroup none rw,cpu
5536 4751 0:26 / /dev/cpuset rw,nosuid,nodev,noexec,relatime master:18 - cgroup none rw,cpuset,noprefix,release_agent=/sbin/cpuset_release_agent
5537 4751 0:27 / /dev/stune rw,nosuid,nodev,noexec,relatime master:19 - cgroup none rw,schedtune
像是常见的控制 CPU 分配的 cpuset,控制 EAS 调度器的 stune,都会在系统启动时被挂载到 /dev 下,每一个这样的“挂载点”被称为一个“层级”(hierarchy)。以上面为例,上面的挂载信息中共有四个“层级”。每个“层级”都可以关联到一个或多个“控制器”(controller)(在挂载时直接绑定)。每个“层级”下又建立有多个“控制组”(control group),通过将任务加入“控制组”并调整“控制组”的参数,即可实现对“层级”所绑定的“控制器”的资源分配。
比如对于 stune “层级”,它在挂载时绑定了 schedtune “控制器”,可以实现对于 EAS scheduler 的资源控制。
系统在其下建立了多个“控制组”,比如foreground、background、top-app、rt:
system/core/rootdir/init.rc
    # Create energy-aware scheduler tuning nodes
    mkdir /dev/stune/foreground
    mkdir /dev/stune/background
    mkdir /dev/stune/top-app
    mkdir /dev/stune/rt
这些“控制组”具有不同的参数(比如调度激进程度),通过将进程加入这些“控制组”即可实现资源分配。也就是说,进程们被按照工作状态分为了几类,每类进程都会被绑定到对应的“控制组”,享受“控制组”限制的资源。
系统与这些 cgroup 的交互通过 libprocessgroup(system/core/libprocessgroup) 模块完成。
好了完美离题,不再继续展开。上面的东西展示了从用户视角看 cgroup v1 是长啥样的,但是 “暂停执行已缓存的应用” 依赖于 cgroup v2 实现。
cgroup v2 vs cgroup v1
Android 系统将 cgroup v2 挂载在了 /sys/fs/cgroup:
6476 6474 0:24 / /sys/fs/cgroup rw,nosuid,nodev,noexec,relatime master:16 - cgroup2 none rwcgroup v2 与 v1 最大的区别是:它只有一个“层级”,并不会像 v1 那样东挂载一个西挂载一个,也不需要通过在挂载时指定参数来绑定“控制器”。
通过在根“层级”下新建文件夹来创建“控制组”(这个和 v1 一样),通过写入节点的方式来为子“控制组”指定可用的“控制器”(这个比 v1 方便的多),再将任务加入对应的“控制组”即可实现资源分配。
“控制组”是可以嵌套创建的,按照设计外层“控制组”施加的限制也会作用到内层,但是这要取决于相关“控制器”的实现(一些比较“抽象”的资源分配就没法做到)。
为了避免冲突,任务只能被增加到最内层的“控制组”,如果从一棵树的角度来理解就是“叶节点”。
具体内容参见 权威的官方文档。
对于 Android 来说,看起来它还完全没有准备好迁移到 cgroup v2。由于所有可用的“控制器”都被关联到了 cgroup v1,因此完全没法用 cgroup v2 来分配资源,就目前来看,v2 就是专门为“暂停执行已缓存的应用”服务的(嗯,冻结是它本身就有的功能,不需要依赖别的“控制器”)。
目前,cgroup v2 工作在以下结构下:/sys/fs/cgroup/uid_<uid>/pid_<pid>
比如对于进程号为 6383 、用户号为 10081 的进程,它会被加入到以下“控制组”中:/sys/fs/cgroup/uid_10081/pid_6383
当它需要被冻结的时候,只需要将其所在的“控制组”冻结即可。echo 1 > /sys/fs/cgroup/uid_10081/pid_6383/cgroup.freeze
而这也正是“暂停执行已缓存的应用”与内核的交互接口。
平台支持
cgroup v2 在 Linux 4.5 就已经被加入,但是 cgroup v2 的 freezer 支持直到 Linux 5.1 才加入。
对于 Android 平台来说,5.4 内核自带完备的 cgroup v2 freezer 支持,而 5.4 以下的内核版本则需要移植。
4.19 内核得到了谷歌的官方移植 —— cgroup v2 freezer 被谷歌反向移植到了 kernel/common 的 android-4.19-stable 分支 上,这可真是“幸运”极了。之所以要带引号,先卖个关子,下面就知道了。
高通平台的开源代码会定期合并谷歌的 kernel/common (前提是它还在积极的维护),于是乎 cgroup v2 freezer 在 CAF Tag LA.UM.9.12.r1-09300-SMxx50.0 进入了高通开源代码。由于这种合并也会造成内核版本的变化,于是对于高通平台,有一种简单粗暴的方法可以判断内核是否支持 cgroup v2 freezer:看内核版本是否大于等于 4.19.152。
系统判断是否支持 cgroup v2 freezer 的方法非常粗暴:
services/core/java/com/android/server/am/CachedAppOptimizer.java
    public static boolean isFreezerSupported() {
        boolean supported = false;
        FileReader fr = null;

        try {
            fr = new FileReader(getFreezerCheckPath());
            char state = (char) fr.read();

            if (state == '1' || state == '0') {
                supported = true;
            } else {
                Slog.e(TAG_AM, "unexpected value in cgroup.freeze");
            }
        } catch (java.io.FileNotFoundException e) {
            Slog.d(TAG_AM, "cgroup.freeze not present");
        } catch (Exception e) {
            Slog.d(TAG_AM, "unable to read cgroup.freeze: " + e.toString());
        }

        if (fr != null) {
            try {
                fr.close();
            } catch (java.io.IOException e) {
                Slog.e(TAG_AM, "Exception closing freezer.killable: " + e.toString());
            }
        }

        return supported;
    }
它直接去尝试读取上面所提及的 cgroup.freeze 节点,如果返回值比较“正常”则直接认为系统支持该功能。
只有在系统支持该功能的时候,开发者选项里才会显示“暂停执行已缓存的应用”设置项。
如果系统支持 cgroup v2 freezer,在 Android 12 以上设备默认启用“暂停执行已缓存的应用”。
因此在 Android 12+ 设备上打开这个选项觉得变省电流畅的,均是幻觉。
工作机制
结构
“暂停执行已缓存的应用” 的核心代码工作在 services/core/java/com/android/server/am/CachedAppOptimizer.java
而 CachedAppOptimizer 则是 OomAdjuster (services/core/java/com/android/server/am/OomAdjuster.java)的一个成员。OomAdjuster 则是 ActivityManagerService (services/core/java/com/android/server/am/ActivityManagerService.java)的一个成员。
从结构上看,这一切都由 AMS 负责,不过这也很正常,毕竟 AMS 负责着应用的生命周期嘛。
OomAdjuster 负责调整与更新应用的 oom_score_adj,它是一个与 lmk (lowmemorykiller) 有关的参数,会被汇报给内核 /proc/<pid>/oom_score_adj,供内核态的 lmk 使用(比如旧的 lowmemorykiller 或者 simple_lmk),用户态的 lmkd 也会读取此参数来决定内存不足时杀应用的顺序。
系统内置了一张表,描述了不同应用类型所对应的 oom_score_adj 优先级。
services/core/java/com/android/server/am/ProcessList.java
    // OOM adjustments for processes in various states:

    // Uninitialized value for any major or minor adj fields
    static final int INVALID_ADJ = -10000;

    // Adjustment used in certain places where we don't know it yet.
    // (Generally this is something that is going to be cached, but we
    // don't know the exact value in the cached range to assign yet.)
    static final int UNKNOWN_ADJ = 1001;

    // This is a process only hosting activities that are not visible,
    // so it can be killed without any disruption.
    static final int CACHED_APP_MAX_ADJ = 999;
    static final int CACHED_APP_MIN_ADJ = 900;

    // This is the oom_adj level that we allow to die first. This cannot be equal to
    // CACHED_APP_MAX_ADJ unless processes are actively being assigned an oom_score_adj of
    // CACHED_APP_MAX_ADJ.
    static final int CACHED_APP_LMK_FIRST_ADJ = 950;

    // Number of levels we have available for different service connection group importance
    // levels.
    static final int CACHED_APP_IMPORTANCE_LEVELS = 5;

    // The B list of SERVICE_ADJ -- these are the old and decrepit
    // services that aren't as shiny and interesting as the ones in the A list.
    static final int SERVICE_B_ADJ = 800;

    // This is the process of the previous application that the user was in.
    // This process is kept above other things, because it is very common to
    // switch back to the previous app.  This is important both for recent
    // task switch (toggling between the two top recent apps) as well as normal
    // UI flow such as clicking on a URI in the e-mail app to view in the browser,
    // and then pressing back to return to e-mail.
    static final int PREVIOUS_APP_ADJ = 700;

    // This is a process holding the home application -- we want to try
    // avoiding killing it, even if it would normally be in the background,
    // because the user interacts with it so much.
    static final int HOME_APP_ADJ = 600;

    // This is a process holding an application service -- killing it will not
    // have much of an impact as far as the user is concerned.
    static final int SERVICE_ADJ = 500;

    // This is a process with a heavy-weight application.  It is in the
    // background, but we want to try to avoid killing it.  Value set in
    // system/rootdir/init.rc on startup.
    static final int HEAVY_WEIGHT_APP_ADJ = 400;

    // This is a process currently hosting a backup operation.  Killing it
    // is not entirely fatal but is generally a bad idea.
    static final int BACKUP_APP_ADJ = 300;

    // This is a process bound by the system (or other app) that's more important than services but
    // not so perceptible that it affects the user immediately if killed.
    static final int PERCEPTIBLE_LOW_APP_ADJ = 250;

    // This is a process hosting services that are not perceptible to the user but the
    // client (system) binding to it requested to treat it as if it is perceptible and avoid killing
    // it if possible.
    static final int PERCEPTIBLE_MEDIUM_APP_ADJ = 225;

    // This is a process only hosting components that are perceptible to the
    // user, and we really want to avoid killing them, but they are not
    // immediately visible. An example is background music playback.
    static final int PERCEPTIBLE_APP_ADJ = 200;

    // This is a process only hosting activities that are visible to the
    // user, so we'd prefer they don't disappear.
    static final int VISIBLE_APP_ADJ = 100;
    static final int VISIBLE_APP_LAYER_MAX = PERCEPTIBLE_APP_ADJ - VISIBLE_APP_ADJ - 1;

    // This is a process that was recently TOP and moved to FGS. Continue to treat it almost
    // like a foreground app for a while.
    // @see TOP_TO_FGS_GRACE_PERIOD
    static final int PERCEPTIBLE_RECENT_FOREGROUND_APP_ADJ = 50;

    // This is the process running the current foreground app.  We'd really
    // rather not kill it!
    static final int FOREGROUND_APP_ADJ = 0;

    // This is a process that the system or a persistent process has bound to,
    // and indicated it is important.
    static final int PERSISTENT_SERVICE_ADJ = -700;

    // This is a system persistent process, such as telephony.  Definitely
    // don't want to kill it, but doing so is not completely fatal.
    static final int PERSISTENT_PROC_ADJ = -800;

    // The system process runs at the default adjustment.
    static final int SYSTEM_ADJ = -900;

    // Special code for native processes that are not being managed by the system (so
    // don't have an oom adj assigned by the system).
    static final int NATIVE_ADJ = -1000;
啊,有点离题了,不再继续展开这个东西了,你只需要知道,数值越小,代表应用的优先级越高,杀后台的优先级越低,越不容易被杀掉。
“已缓存的应用” 的优先级非常低。从上表可以看到,它们高高位于表的顶端,再往上只有 “未知” 和 “无效” 了。
也就是说,当内存不足时,“已缓存的应用”是会被第一时间回收掉的,甚至连一般的“后台服务”都比它们生命力强的多。
挑战一:优先级
那么什么是“已缓存的应用”呢?我们可以用排除法。一个应用,要想成为“已缓存的应用”,得不在前台,得不能是刚刚切到后台,得不可见(比如不能有悬浮窗),得难以察觉(比如不能在后台放音乐),还得不能有后台服务。什么样的应用能如此卑微?说白了,这个应用本身得足够老实,没什么后台功能,它呆在后台的唯一作用是为了切回去不用重新加载,那么它才有“资格”沦为“已缓存的应用”。
OomAdjuster 是负责更新这个东西的,那么也就是说,它会被 AMS 中的其它组件在进程生命周期的适宜时机被调用,第一时间掌握 OOM 优先级改变的信息。
我们的主角 CachedAppOptimizer 是它的一个成员,为它所操纵,根据新拿到的 OOM 优先级执行相关操作:
services/core/java/com/android/server/am/OomAdjuster.java
    @GuardedBy({"mService", "mProcLock"})
    private void updateAppFreezeStateLSP(ProcessRecord app) {
        if (!mCachedAppOptimizer.useFreezer()) {
            return;
        }

        if (app.mOptRecord.isFreezeExempt()) {
            return;
        }

        final ProcessCachedOptimizerRecord opt = app.mOptRecord;
        // if an app is already frozen and shouldNotFreeze becomes true, immediately unfreeze
        if (opt.isFrozen() && opt.shouldNotFreeze()) {
            mCachedAppOptimizer.unfreezeAppLSP(app);
            return;
        }

        final ProcessStateRecord state = app.mState;
        // Use current adjustment when freezing, set adjustment when unfreezing.
        if (state.getCurAdj() >= ProcessList.CACHED_APP_MIN_ADJ && !opt.isFrozen()
                && !opt.shouldNotFreeze()) {
            mCachedAppOptimizer.freezeAppAsyncLSP(app);
        } else if (state.getSetAdj() < ProcessList.CACHED_APP_MIN_ADJ) {
            mCachedAppOptimizer.unfreezeAppLSP(app);
        }
    }
freezeAppAsyncLSP() 是准备冻结应用的方法,方法名中的 LSP 大概指的是 Lock mService mProcLock,代表了调用这个方法之前必须取得这俩锁。
可以看到,冻结的必要不充分条件是:进程的 OOM 优先级数值大于 CACHED_APP_MIN_ADJ,也就是说,只有进程是“已缓存的应用”或者比它们更不重要才有机会被冻结。而从上面的介绍中我们已经知道,被标记为“已缓存的应用”的进程基本已经是属于最不重要的那种了。但是,调用了这个“准备冻结”方法,应用的进程马上就被冻结了吗?别急,还有层层挑战在后面等着。
挑战二:消抖
services/core/java/com/android/server/am/CachedAppOptimizer.java
    void freezeAppAsyncLSP(ProcessRecord app) {
        final ProcessCachedOptimizerRecord opt = app.mOptRecord;
        if (opt.isPendingFreeze()) {
            // Skip redundant DO_FREEZE message
            return;
        }

        mFreezeHandler.sendMessageDelayed(
                mFreezeHandler.obtainMessage(
                    SET_FROZEN_PROCESS_MSG, DO_FREEZE, 0, app),
                mFreezerDebounceTimeout);
        opt.setPendingFreeze(true);
        if (DEBUG_FREEZER) {
            Slog.d(TAG_AM, "Async freezing " + app.getPid() + " " + app.processName);
        }
    }
freezeAppAsyncLSP() 所做的事情是准备(看方法名中的 Async 可知它并不会立刻开始冻结),它将进程设置为了“等待冻结”的状态,并利用 Handler 的 sendMessageDelayed() 设定了一个延时消息事件发送:这条消息(SET_FROZEN_PROCESS_MSG)将会在 mFreezerDebounceTimeout 后才被 Handler 本体收到:
services/core/java/com/android/server/am/CachedAppOptimizer.java
    private final class FreezeHandler extends Handler {
        ......

        @Override
        public void handleMessage(Message msg) {
            switch (msg.what) {
                case SET_FROZEN_PROCESS_MSG:
                    synchronized (mAm) {
                        freezeProcess((ProcessRecord) msg.obj);
                    }
                    break;
                ......
            }
        }
        ......
而在 Handler 本体收到这一消息后,真正的冻结才会开始。
嗯,所以在准备冻结后,至少要等待 mFreezerDebounceTimeout 的时长,Handler 才会收到消息,冻结才会开始,对吗?
不完全正确,因为它可能就不会开始:
services/core/java/com/android/server/am/CachedAppOptimizer.java
    void unfreezeAppLSP(ProcessRecord app) {
        final int pid = app.getPid();
        final ProcessCachedOptimizerRecord opt = app.mOptRecord;
        if (opt.isPendingFreeze()) {
            // Remove pending DO_FREEZE message
            mFreezeHandler.removeMessages(SET_FROZEN_PROCESS_MSG, app);
            opt.setPendingFreeze(false);
            if (DEBUG_FREEZER) {
                Slog.d(TAG_AM, "Cancel freezing " + pid + " " + app.processName);
            }
        }
        ......
}假如在等待的过程中,unfreezeAppLSP() 被调用,也就是说,应用被请求解除冻结,那么,这个“设置冻结”的“延时消息事件”将会被直接被移除,这条消息也将永远无法被 Handler 收到,冻结也永远不会开始。
services/core/java/com/android/server/am/CachedAppOptimizer.java
    void unfreezeTemporarily(ProcessRecord app) {
        if (mUseFreezer) {
            synchronized (mProcLock) {
                if (app.mOptRecord.isFrozen() || app.mOptRecord.isPendingFreeze()) {
                    unfreezeAppLSP(app);
                    freezeAppAsyncLSP(app);
                }
            }
        }
}又比如说这个方法?unfreezeTemporarily() 方法进行了一个更高级的封装,它先调用 unfreezeAppLSP() 移除上一条延时消息,然后又调用 freezeAppAsyncLSP() 再准备发送一条延时消息,这是干了啥呢?嗯,重置计时器。说白了,刚刚等待过的时间不算,现在得重新等待 mFreezerDebounceTimeout 的时长,冻结才会真正开始。
也就是说,在这个等待冻结的缓冲时间内,倒计时可能会被重置,也有可能会被直接取消。
什么时候会取消或重置呢?
比如这个进程不再是“已缓存的应用”了,等待中的冻结会被直接取消:
services/core/java/com/android/server/am/OomAdjuster.java
    } else if (state.getSetAdj() < ProcessList.CACHED_APP_MIN_ADJ) {
        mCachedAppOptimizer.unfreezeAppLSP(app);
    }
又比如说有一个广播即将发往目标进程,等待中的冻结倒计时会被重置:
services/core/java/com/android/server/am/BroadcastQueue.java
    } else if (filter.receiverList.app != null) {
        mService.mOomAdjuster.mCachedAppOptimizer.unfreezeTemporarily(filter.receiverList.app);
}对了,unfreezeAppLSP() 的本职工作是“解冻已被冻结的应用”,取消等待中的冻结只能算是其准备工作中的一小部分。
因此,对于上面两种情况:不再是已缓存的应用会被解冻;如果一个广播被发往已冻结的应用,那么目标应用会被解冻,并且由于冻结倒计时重新开始,它会至少经过 mFreezerDebounceTimeout 的时长才会再次被尝试冻结。
为什么要等待?为什么不直接冻住呢?为的是“消抖”。
这种“消抖”有什么作用呢?想象一下:假如 freezeAppAsyncLSP() 后一毫秒来了个 unfreezeAppLSP(),如果没有这个“延时”过程,那么应用将会被冻结又马上重新解冻,这不是纯纯的资源浪费吗?假如一个应用经常在后台收到广播,如果不“消抖”,那频繁的冻结和解冻不也显得很没必要吗?
“消抖”为真正的冻结提供了一段缓冲时间,只有在这段时间内保持平静,冻结才会真正开始,以此确保冻结的是那些真正需要冻结的应用。
那么等待冻结的缓冲时间 mFreezerDebounceTimeout 默认是多少呢?十秒?半分钟?不,是十分钟:
services/core/java/com/android/server/am/CachedAppOptimizer.java
@VisibleForTesting static final long DEFAULT_FREEZER_DEBOUNCE_TIMEOUT = 600_000L;也就是说,应用至少要进缓存十分钟,而且在这十分钟内安静老实还无所事事才有机会被冻结,稍有风吹草动不仅会被解冻,倒计时还会重置,冻结仿佛成了一种珍贵高雅的享受。
由此我们也可以看出“暂停执行已缓存的应用”的设计思路:它根本就不是用来压制后台应用的,后台应用随便跳一跳就能使它失效;它的作用对象就是那些真正“小而美”的应用——将安静的它们冻住来稍微节省那么一点点的电量。
不过这个“十分钟”是默认值,还是有机会对其进行调整的,虽然我觉得调整它并不能使更多的应用被冻住。
你可以通过 DeviceConfig,对 activity_manager_native_boot 命名空间中的 freeze_debounce_timeout 属性进行调整,从而改变默认的“消抖时间”。
对 DeviceConfig 的介绍,详见此处。
挑战三:冻结
别以为经过了那难熬的十分钟,开始冻结了,一切就万事大吉了。
接下来把目光聚焦在消抖延时结束后,Handler 收到消息后,真正会调用的冻结函数,来看看距离真正的冻结还要卖过几道坎:
services/core/java/com/android/server/am/CachedAppOptimizer.java
        private void freezeProcess(final ProcessRecord proc) {
            int pid = proc.getPid(); // Unlocked intentionally
            final String name = proc.processName;
            final long unfrozenDuration;
            final boolean frozen;
            final ProcessCachedOptimizerRecord opt = proc.mOptRecord;

            opt.setPendingFreeze(false);

            try {
                // pre-check for locks to avoid unnecessary freeze/unfreeze operations
                if (mProcLocksReader.hasFileLocks(pid)) {
                    if (DEBUG_FREEZER) {
                        Slog.d(TAG_AM, name + " (" + pid + ") holds file locks, not freezing");
                    }
                    return;
                }
            } catch (Exception e) {
                Slog.e(TAG_AM, "Not freezing. Unable to check file locks for " + name + "(" + pid
                        + "): " + e);
                return;
            }

            synchronized (mProcLock) {
                pid = proc.getPid();
                if (proc.mState.getCurAdj() < ProcessList.CACHED_APP_MIN_ADJ
                        || opt.shouldNotFreeze()) {
                    if (DEBUG_FREEZER) {
                        Slog.d(TAG_AM, "Skipping freeze for process " + pid
                                + " " + name + " curAdj = " + proc.mState.getCurAdj()
                                + ", shouldNotFreeze = " + opt.shouldNotFreeze());
                    }
                    return;
                }

                if (mFreezerOverride) {
                    opt.setFreezerOverride(true);
                    Slog.d(TAG_AM, "Skipping freeze for process " + pid
                            + " " + name + " curAdj = " + proc.mState.getCurAdj()
                            + "(override)");
                    return;
                }

                if (pid == 0 || opt.isFrozen()) {
                    // Already frozen or not a real process, either one being
                    // launched or one being killed
                    return;
                }

                Slog.d(TAG_AM, "freezing " + pid + " " + name);

                // Freeze binder interface before the process, to flush any
                // transactions that might be pending.
                try {
                    if (freezeBinder(pid, true) != 0) {
                        rescheduleFreeze(proc, "outstanding txns");
                        return;
                    }
                } catch (RuntimeException e) {
                    Slog.e(TAG_AM, "Unable to freeze binder for " + pid + " " + name);
                    mFreezeHandler.post(() -> {
                        synchronized (mAm) {
                            proc.killLocked("Unable to freeze binder interface",
                                    ApplicationExitInfo.REASON_OTHER,
                                    ApplicationExitInfo.SUBREASON_FREEZER_BINDER_IOCTL, true);
                        }
                    });
                }

                long unfreezeTime = opt.getFreezeUnfreezeTime();

                try {
                    Process.setProcessFrozen(pid, proc.uid, true);

                    opt.setFreezeUnfreezeTime(SystemClock.uptimeMillis());
                    opt.setFrozen(true);
                } catch (Exception e) {
                    Slog.w(TAG_AM, "Unable to freeze " + pid + " " + name);
                }

                unfrozenDuration = opt.getFreezeUnfreezeTime() - unfreezeTime;
                frozen = opt.isFrozen();
            }

            if (!frozen) {
                return;
            }

            Slog.d(TAG_AM, "froze " + pid + " " + name);

            EventLog.writeEvent(EventLogTags.AM_FREEZE, pid, name);

            // See above for why we're not taking mPhenotypeFlagLock here
            if (mRandom.nextFloat() < mFreezerStatsdSampleRate) {
                FrameworkStatsLog.write(FrameworkStatsLog.APP_FREEZE_CHANGED,
                        FrameworkStatsLog.APP_FREEZE_CHANGED__ACTION__FREEZE_APP,
                        pid,
                        name,
                        unfrozenDuration);
            }

            try {
                // post-check to prevent races
                int freezeInfo = getBinderFreezeInfo(pid);

                if ((freezeInfo & TXNS_PENDING_WHILE_FROZEN) != 0) {
                    synchronized (mProcLock) {
                        rescheduleFreeze(proc, "new pending txns");
                    }
                    return;
                }
            } catch (RuntimeException e) {
                Slog.e(TAG_AM, "Unable to freeze binder for " + pid + " " + name);
                mFreezeHandler.post(() -> {
                    synchronized (mAm) {
                        proc.killLocked("Unable to freeze binder interface",
                                ApplicationExitInfo.REASON_OTHER,
                                ApplicationExitInfo.SUBREASON_FREEZER_BINDER_IOCTL, true);
                    }
                });
            }

            try {
                // post-check to prevent races
                if (mProcLocksReader.hasFileLocks(pid)) {
                    if (DEBUG_FREEZER) {
                        Slog.d(TAG_AM, name + " (" + pid + ") holds file locks, reverting freeze");
                    }
                    unfreezeAppLSP(proc);
                }
            } catch (Exception e) {
                Slog.e(TAG_AM, "Unable to check file locks for " + name + "(" + pid + "): " + e);
                unfreezeAppLSP(proc);
            }
}首先,被冻结的目标进程不能持有文件锁:
services/core/java/com/android/server/am/CachedAppOptimizer.java
    try {
        // pre-check for locks to avoid unnecessary freeze/unfreeze operations
        if (mProcLocksReader.hasFileLocks(pid)) {
            if (DEBUG_FREEZER) {
                Slog.d(TAG_AM, name + " (" + pid + ") holds file locks, not freezing");
            }
            return;
        }
    } catch (Exception e) {
        Slog.e(TAG_AM, "Not freezing. Unable to check file locks for " + name + "(" + pid
                + "): " + e);
        return;
    }
在 Android 中,文件锁只能是需要应用主动查询,并没有强制约束作用的 Advisory Locking,它一般使用 java 层的 FileChannel 创建,方便多进程访问同一文件时的安排与配合。
文件锁可以通过 /proc/locks 进行查看,其中 fd 左边那列记录着持有锁的进程号:
OnePlus8T:/ # cat /proc/locks
1: POSIX  ADVISORY  READ  2048 fd:1c:2173 128 128
2: POSIX  ADVISORY  READ  2048 fd:1c:2168 1073741826 1073742335
3: POSIX  ADVISORY  READ  3512 fd:1c:2854 128 128
4: POSIX  ADVISORY  READ  4573 fd:1c:10117 128 128
5: POSIX  ADVISORY  READ  4573 fd:1c:10114 1073741826 1073742335
6: POSIX  ADVISORY  READ  4194 fd:1c:8732 128 128
7: POSIX  ADVISORY  READ  4194 fd:1c:8727 1073741826 1073742335
8: POSIX  ADVISORY  READ  4194 fd:1c:8647 1073741826 1073742335
9: POSIX  ADVISORY  READ  3512 fd:1c:2979 128 128
10: POSIX  ADVISORY  READ  3512 fd:1c:2970 1073741826 1073742335
11: POSIX  ADVISORY  WRITE 1560 fd:1c:396 0 EOF
12: POSIX  ADVISORY  READ  4573 fd:1c:10205 128 128
13: POSIX  ADVISORY  READ  4573 fd:1c:10201 1073741826 1073742335
14: POSIX  ADVISORY  READ  4194 fd:1c:8650 128 128
15: POSIX  ADVISORY  READ  3512 fd:1c:2851 1073741826 1073742335
至于为什么要跳过冻结持有文件锁的进程,大概是怕冻结后造成死锁吧。虽然 Advisory Locking 没有强制效力,但由于文件锁的使用者的密切配合,死锁并不是不能产生的。
这其实也教会了毒瘤应用们一招:随便找个文件上个锁就能轻松规避冻结。不过对于后台一堆服务的毒瘤应用,单是成为“已缓存的应用”就难以满足,压根就不需要走到这一步。
接下来,将会尝试对目标进程的 binder 接口尝试冻结:
services/core/java/com/android/server/am/CachedAppOptimizer.java
    try {
        if (freezeBinder(pid, true) != 0) {
            rescheduleFreeze(proc, "outstanding txns");
            return;
        }
    } catch (RuntimeException e) {
        Slog.e(TAG_AM, "Unable to freeze binder for " + pid + " " + name);
        mFreezeHandler.post(() -> {
            synchronized (mAm) {
                proc.killLocked("Unable to freeze binder interface",
                        ApplicationExitInfo.REASON_OTHER,
                        ApplicationExitInfo.SUBREASON_FREEZER_BINDER_IOCTL, true);
            }
        });
    }
调用 freezeBinder() 时会进入 native 层:
services/core/jni/com_android_server_am_CachedAppOptimizer.cpp
static jint com_android_server_am_CachedAppOptimizer_freezeBinder(
        JNIEnv *env, jobject clazz, jint pid, jboolean freeze) {

    jint retVal = IPCThreadState::freeze(pid, freeze, 100 /* timeout [ms] */);
    if (retVal != 0 && retVal != -EAGAIN) {
        jniThrowException(env, "java/lang/RuntimeException", "Unable to freeze/unfreeze binder");
    }

    return retVal;
}
并最终通过向 binder 设备发起 ioctl() 的方式进入内核态:
frameworks/native/libs/binder/IPCThreadState.cpp
status_t IPCThreadState::freeze(pid_t pid, bool enable, uint32_t timeout_ms) {
    struct binder_freeze_info info;
    int ret = 0;

    info.pid = pid;
    info.enable = enable;
    info.timeout_ms = timeout_ms;


#if defined(__ANDROID__)
    if (ioctl(self()->mProcess->mDriverFD, BINDER_FREEZE, &info) < 0)
        ret = -errno;
#endif

    //
    // ret==-EAGAIN indicates that transactions have not drained.
    // Call again to poll for completion.
    //
    return ret;
}
在内核中,驱动会尝试等待目标进程把未完成的 binder transaction 处理完,再将其设置为 “不再接收 binder transaction” 的状态:
static int binder_ioctl_freeze(struct binder_freeze_info *info,
                   struct binder_proc *target_proc)
{
    int ret = 0;

    if (!info->enable) {
        binder_inner_proc_lock(target_proc);
        target_proc->sync_recv = false;
        target_proc->async_recv = false;
        target_proc->is_frozen = false;
        binder_inner_proc_unlock(target_proc);
        return 0;
    }

    /*
     * Freezing the target. Prevent new transactions by
     * setting frozen state. If timeout specified, wait
     * for transactions to drain.
     */
    binder_inner_proc_lock(target_proc);
    target_proc->sync_recv = false;
    target_proc->async_recv = false;
    target_proc->is_frozen = true;
    binder_inner_proc_unlock(target_proc);

    if (info->timeout_ms > 0)
        ret = wait_event_interruptible_timeout(
            target_proc->freeze_wait,
            (!target_proc->outstanding_txns),
            msecs_to_jiffies(info->timeout_ms));

    /* Check pending transactions that wait for reply */
    if (ret >= 0) {
        binder_inner_proc_lock(target_proc);
        if (binder_txns_pending_ilocked(target_proc))
            ret = -EAGAIN;
        binder_inner_proc_unlock(target_proc);
    }

    if (ret < 0) {
        binder_inner_proc_lock(target_proc);
        target_proc->is_frozen = false;
        binder_inner_proc_unlock(target_proc);
    }

    return ret;
}
这个过程中发生的任何错误都将会逐级返回,最终回到 CachedAppOptimizer 供处理。
看起来错误被分为两类,一类是内核的 binder 驱动中,“等待目标进程把未完成的 binder transaction 处理完” 超时,返回 -EAGAIN ,此时上层会重新安排下一次冻结。
另一类是“其它错误”,此时上层将会直接杀死目标进程。
在冻结 binder 接口后,真正的冻结进程本体才会开始(啊,终于终于开始了),它由 Process.setProcessFrozen() 进行,这个方法会进入 native 层,最终由 libprocessgroup 模块写入 cgroup,完成冻结。
在冻结完成后,还会有一些收尾工作,这里就不再展开了,主要包括:再检测一次是不是真的没有文件锁,如果文件锁突然出现了那就把目标解冻;再检测一次 binder 接口的冻结情况,如果出了问题那就再杀死进程。
于是,冻结的流程结束了,但有意思的事情还没有结束。
翻大车
对上面的冻结 binder 接口,什么时候会发生“其它错误”呢?在内核根本就不支持目标 ioctl 操作码 BINDER_FREEZE 的时候。
诶,内核难道不是只需要支持 cgroup v2 freezer 就够了吗?看到这里,很显然不是的。
假如内核不支持 cgroup v2 freezer,那么“暂停执行已缓存的应用”不会工作,也没有副作用。但是假如内核支持 cgroup v2 freezer 但不支持 binder freeze,那么“暂停执行已缓存的应用”将会变成隐形的后台杀手,凡是符合冻结要求的应用不但不会被冻结,还会被直接杀死。
(回去看看上面,这个功能的兼容性检查只检查了 cgroup v2 freezer ,并没有检测 binder freeze 的支持情况)
诶,别忘了我们上面说 cgroup v2 freezer 被反向移植到了 kernel/common 的 4.19 内核,并被合并到了高通平台的 4.19 内核上,那么 binder freeze 呢?很遗憾,binder freeze 并没有被移植。也就是说,上面说的那些十分“幸运”的,得到了移植的 4.19 内核设备,不仅没法成功冻结应用,还会加大杀后台的力度。笑拉了。
问题归根结底出在谷歌没有没有把这个功能需要的修改完整移植到 kernel/common 上,高通一合并,直接喜提受害者身份,不知道这一波会祸害多少设备。
对于这些超惨的 4.19 内核设备,你可以从 Pixel 5 的内核 处获得加入 binder freeze 支持的相关提交(嗯,没错,是私货,kernel/common 不给,自家 Pixel 倒是用上了)。
简单看了下,相关的提交应该有以下8个:
BACKPORT: FROMGIT: binder: fix freeze race
UPSTREAM: binder: add flag to clear buffer on txn complete
binder: don't unlock procs while scanning contexts
binder: don't log on EINTR
binder: freeze multiple contexts
binder: use EINTR for interrupted wait for work
binder: introduce the BINDER_GET_FROZEN_INFO ioctl
binder: implement BINDER_FREEZE ioctl
其实谷歌是尝试把这些补丁下放给 kernel/common 了,但是由于 android-4.19-stable 的新特性合并窗口已经关闭,然后又自己否决了。。。
哈?你不信谷歌会犯下这么愚蠢的错误?
那我们来看看日志,它甚至更加愚蠢:
D ActivityManager: freezing 6186 org.chromium.chrome
E ActivityManager: Unable to freeze binder for 6186 org.chromium.chrome
I binder  : 1245:1848 ioctl 400c620e 761c1be5e8 returned -22
I binder  : 1245:1848 ioctl c00c620f 761c1be5c8 returned -22
D ActivityManager: froze 6186 org.chromium.chrome
再来结合一下上面的代码:
    Slog.d(TAG_AM, "freezing " + pid + " " + name);

    // Freeze binder interface before the process, to flush any
    // transactions that might be pending.
    try {
        if (freezeBinder(pid, true) != 0) {
            rescheduleFreeze(proc, "outstanding txns");
            return;
        }
    } catch (RuntimeException e) {
        Slog.e(TAG_AM, "Unable to freeze binder for " + pid + " " + name);
        mFreezeHandler.post(() -> {
            synchronized (mAm) {
                proc.killLocked("Unable to freeze binder interface",
                        ApplicationExitInfo.REASON_OTHER,
                        ApplicationExitInfo.SUBREASON_FREEZER_BINDER_IOCTL, true);
            }
        });
    }

    long unfreezeTime = opt.getFreezeUnfreezeTime();

    try {
        Process.setProcessFrozen(pid, proc.uid, true);

        opt.setFreezeUnfreezeTime(SystemClock.uptimeMillis());
        opt.setFrozen(true);
    } catch (Exception e) {
        Slog.w(TAG_AM, "Unable to freeze " + pid + " " + name);
    }

    unfrozenDuration = opt.getFreezeUnfreezeTime() - unfreezeTime;
    frozen = opt.isFrozen();
}

if (!frozen) {
    return;
}

Slog.d(TAG_AM, "froze " + pid + " " + name);
你就会发现,诶,binder 确实发生错误了,进程确实是被 kill 了,但程序没有 return (它是异步的也没法 return),它接着往下跑,借着进程从被杀到死之间的一点时间,一路向下甚至打印出了 froze xxx。要知道,这条日志在正常情况下可代表着“冻结完成”,于是乎它就凭空给调试增加了许多难度,给人带来它正在正常工作的幻觉。
可笑可笑真是可笑。
总结
看到这里,相信你已经明白了“暂停执行已缓存的应用”和“墓碑后台”之间的关系了吧——可以说没有半点关系。这玩意儿,工作起来一半得看应用的意愿,冻住应用要经过一个又一个的挑战,最后能冻住的“毒瘤应用”,不能说非常少,只能说根本没有。它的设计初衷一直就是“在不破坏应用功能的前提下稍微省一点电”,而“成为毒瘤”正是“毒瘤应用”的功能,系统总不能为了它们,破坏自己的功能设计,自断双臂吧?
后记
慢慢写完这篇文章的时候 Android 13 已经发布了,看了看提交历史,谷歌 终于终于注意到了 上面 “翻大车” 的问题。但遗憾的是谷歌给出的修复是为那些巨惨的合并了 kernel/common 的 4.19 内核设备直接砍掉这个功能。相信一定有人会疑惑为什么升级到安卓 13 之后这个功能为啥在开发者选项里找不到了呢?究竟是该感到高兴还是悲伤呢?
我在想安卓子系统,应该怎么去关闭后台,因为点了叉叉之后应用实际上还在运行,但是他又没有那种任务管理界面应该怎么做才好呢?
我这边用过来,只要“子系统资源”被设置为了“按需要”,WSA 会在所有应用被叉掉之后的一段时间自己停止运行。
三星one ui 5(基于Android13)在开发者选项里依然有暂停执行缓存的应用程序启动开关
学到了,可以去出击yxh了
没想到找不到这个设置 居然不是 自己手机厂商给裁掉的
看完这篇文章,这功能还不如手机厂系统的调度